一键直出3分钟一集短剧,MiniMax测试实录,小白可用
- 2026-11-19 17:36:03
“爸,你能不能别这么说话?”
“我李建华怎么就生了你这么个没出息的儿子!”
当这两句台词配上画面、从角色嘴里真实说出来,配上父亲气得发抖的手指、母亲端着荷包蛋为难的神情——你会很难相信,这整段 2分49秒、22个镜头的竖屏短剧,是一键出来的,配上agent skill,不用烧脑,当然还不完美,还有继续提炼。
这就是我用 MiniMax H3 视频模型做的第一次完整短剧实测。没有拍摄、没有演员、没有剪辑师,只有提示词、参考图和一台显卡。
但这篇文章不写"一键出片"的广告话术。我要把完整的测试链路、每一个节点怎么连、参数怎么填、提示词怎么写、踩过的四个大坑全部摊开。你照着做,能省掉我烧掉的算力和两天弯路。
一、整体架构:一个人 + ComfyUI + H3
整个流程是一条链:
角色定妆图 + 场景空镜(参考图)
↓
H3OneNode(魔改版,Chain 模式)一个节点装整集 22 镜
↓ 每段:六段式提示词 + 时长 + 参考图
点 Generate → 内部展开 314 节点工作流 → 逐段渲染 + 运动衔接
↓
自动拼接 → 完整一集
核心是 MiniMax 的 Ref2VA(参考图生成视频) 能力:给它角色图、场景图,它就能让指定角色在指定场景里动起来、说话、运镜。这正是剧情短剧需要的——人物一致、场景一致、对话对口型。而 H3OneNode 的 Chain 模式把这个能力包装成"一个节点装整集"的一键直出体验。
二、测试环境(照抄可用)
| ComfyUI-ALLinONE-MinimaxH3-AIFSH(魔改版) | |
三、工作流:一个节点搞定整集(ALL in ONE + Chain)
这才是真正的"一键直出"——**不是搭 18 个节点连线,而是用 H3OneNode 一个节点,把整集 22 镜全装进去**。
3.1 选对版本:魔改版才有 Chain 参考图
ALL in ONE 节点有两个版本,**必须用魔改版(AIFSH)**:
✅ 魔改版 = ComfyUI-ALLinONE-MinimaxH3-AIFSH:有 Audio Lock 音频锁、音频驱动长视频、Chain 模式每段参考图⚠️ 官方版 = ComfyUI-ALLinONE-MinimaxH3:基础版,Chain 模式根本没有参考图上传位——做不了短剧- 判断方法
:节点面板里有 Audio Lock开关 = 魔改版
3.2 H3OneNode 节点结构(Chain 模式)
画布上只有一个大节点 ALL in ONE MiniMaxH3,面板分几块:
| 模式栏 | |
| Prompt | |
| Motion Context | |
| Clips | + Add clip 加段) |
| Tune | |
| Generate |
3.3 Chain 模式怎么用(核心)
Chain = 链式生成整集:一个节点管理多段 clip,点一次 Generate,逐段渲染 + Motion Context 运动衔接自动拼接,副标题原话:Clips generated in sequence, stitched with motion-context continuity.
操作流程(第1集 22 镜真实做法):
- 切到 Chain 模式
(点模式栏的"链") - 上传参考图到 Motion Context
(Add image,按顺序传角色图+场景图) 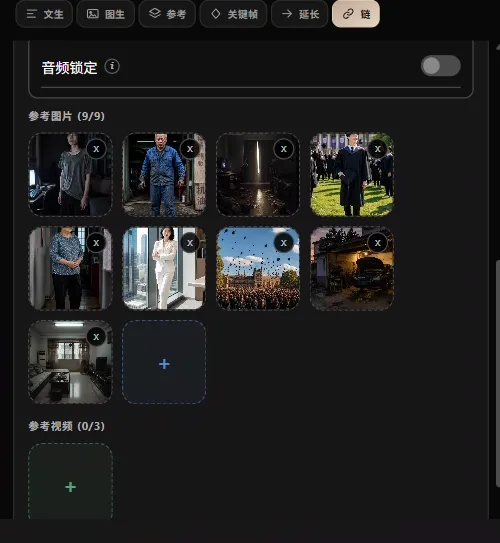
+ Add clip加到 22 段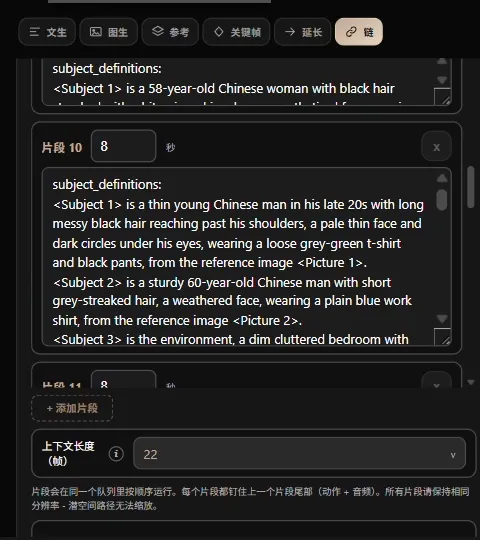
- 每段填提示词 + 时长
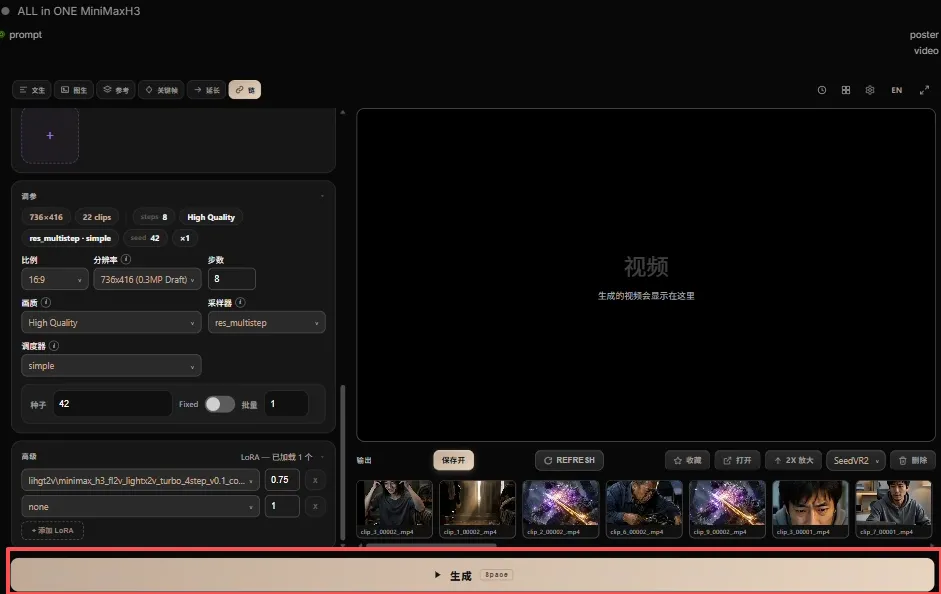
: 提示词:六段式(见下节),每镜一份 时长:镜01=6s、镜02=8s…按分镜表(duration 字段)填入每一段的提示词,六段式英文提示词,官方skill,提示词可以叫agent帮你写。 加载四部加速lora
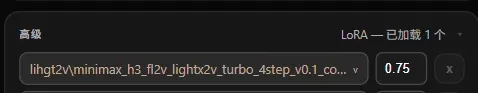
注意:路径含 /会当子目录,渲染后要确认文件真落盘
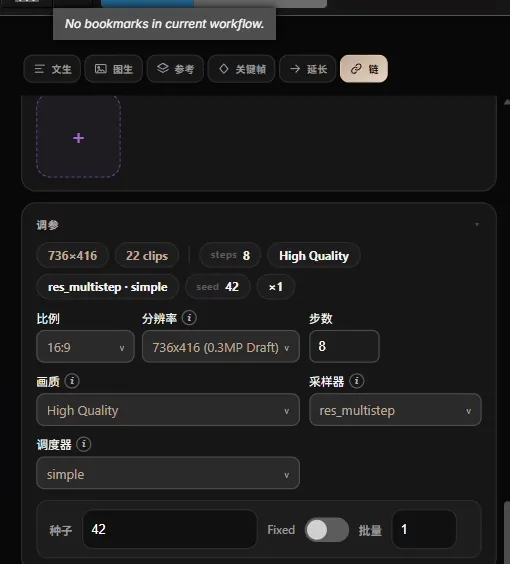
四、提示词怎么写:官方六段式
这是整个流程最核心、最容易错的部分。H3 的参考图视频,提示词要求六段式,每段管一件事:
subject_definitions | <Subject 1> is a thin young Chinese man... from <Picture 1> | |
summary | [reference generation] 门被推开,父亲怒斥... | |
retention_analysis | fully_preserved - appearance and identity retained | |
detailed_description | [Shot 1] a single continuous shot... camera pushes in... | |
overall_soundscape | The loud bang of the door hitting the wall | |
non_diegetic_music | A sudden tense sting at a fast tempo |
对象标记:<Subject N> 怎么用
参考图里的每一个"人/物/场景"都要在 subject_definitions 里起一个名字。规则:
<Subject 1>、<Subject 2>、<Subject 3>:按出场顺序编号 <Picture 1>、<Picture 2>、<Picture 3>:对应你上传的第 1/2/3 张参考图 每定义一个 Subject,必须写清"长什么样 + 对应哪张图",例如:
<Subject 1> is Li Wei in <Picture 1>, a thin young Chinese man in his late 20s
with long messy black hair reaching past his shoulders, a pale thin face and
dark circles under his eyes, wearing a loose grey-green t-shirt and black pants.
环境标记:场景也是 Subject
环境(房间/背景)必须单独定义,和角色一样用 <Subject N>,否则画面背景会自由漂移——这是场景一致性的唯一保障:
<Subject 3> is the bedroom environment in <Picture 3>, a dim cluttered room
with dark grey curtains in the center, a bed on the right, a desk on the left
with a purple-backlit keyboard, and trash on the floor.
⚠️ 血泪教训:单张场景空镜约束不住切镜后的背景。每个关键场景至少 3 张不同机位的空镜(门口/床边/书桌角)一起做参考图,切换机位时背景才不会漂到车间、更衣室去。
说话在哪:<d> 对话标记
台词必须用 <d>[语言] 内容</d> 标签包起来,模型才知道"这里要出声说话":
<Subject 2> (S2), the father with short grey-streaked hair... His trembling finger
points at his son. He shouts in a deep, furious male voice shaking with anger,
<d>[Chinese] 你碍着我了!我李建华怎么就生了你这么个没出息的儿子!</d>
规则:
(S2):说话人 ID,谁说话标谁,全片不变 <d>[Chinese]:语言标签 + 台词原话,**逐字保留**,不要翻译 - 角色动作/语气写在
<d>外面, <d>里只放台词本身
旁白在哪:off-screen voiceover
旁白(画外音)用精确短语 says in an off-screen voiceover,而且必须写"嘴唇不动",否则模型会给旁白配上一个乱动的嘴:
The narrator (S3) says in an off-screen voiceover:
<d>[Chinese] 三年了,他把自己关在这间屋里。</d>
while his lips remain completely closed.
⚠️ 血泪教训:旁白和台词必须分开写、分开标 ID。把"冲出房间"这种动作写进旁白、或把旁白和父亲的台词混在一段里,成片就会听到父亲的声音在读旁白,甚至旁白突然变成女声。
音效在哪:overall_soundscape
物理音效(门响、咳嗽、环境声)**不写进台词**,单独写在 overall_soundscape 段:
overall_soundscape: The low hum of the computer and room tone persist throughout.
The father's heavy breathing and the creak of the gaming chair punctuate the
tense silence between their lines.
真实段落拆解:镜08 父子对峙(完整示例)
我们第1集镜08的完整提示词(父子对峙那场戏):
① 定义三个对象(李伟 + 父亲 + 卧室):
subject_definitions:
<Subject 1> is Li Wei in <Picture 1>, ...long messy black hair... grey-green t-shirt...
<Subject 2> is the father Li Jianhua in <Picture 2>, ...short grey-streaked hair... blue work shirt...
<Subject 3> is the bedroom environment in <Picture 3>, ...dark grey curtains... purple-backlit keyboard...
② summary(一句话剧情):
summary:
[reference generation] The target video shows <Subject 1> and <Subject 2> confronting
each other inside <Subject 3>. <Subject 1> defends himself from his gaming chair while
<Subject 2> stands at the door pointing and shouting.
③ retention_analysis(保真声明):
retention_analysis:
<Subject 1> ... fully_preserved - Li Wei's long hair, pale thin face, grey-green t-shirt...
<Subject 2> ... fully_preserved - the father's short grey hair, weathered face, blue work shirt...
<Subject 3> ... fully_preserved - the same bedroom with dark grey curtains, bed, desk...
④ detailed_description(分镜剧本 + 对话标记):
detailed_description:
[Shot 1] A medium shot establishes <Subject 3>, the dim cluttered bedroom...
<Subject 1> (S1) sits half-turned in the gaming chair, neck craned defiantly toward the door.
He shoots back at his father in a low male voice, defensive but trembling with guilt,
speaking at a fast rate, <d>[Chinese] 我怎么了?我没偷没抢,在家待着碍着谁了?</d>
He clenches his t-shirt hem nervously as the camera pushes in slightly.
[Shot 2] At 00:04.000, the shot cuts to a close-up of <Subject 2> (S2)...
He shouts in a deep, furious male voice shaking with anger,
<d>[Chinese] 你碍着我了!我李建华怎么就生了你这么个没出息的儿子!
我像你这么大的时候,你都能打酱油了!你呢?连自己都养不活!</d>
His hand trembles with rage. The camera holds the static close-up on his furious face.
⑤ overall_soundscape(音效分层):
overall_soundscape: The low hum of the computer and room tone persist throughout.
The father's heavy breathing and the creak of the gaming chair punctuate the tense silence.
⑥ non_diegetic_music(配乐):
non_diegetic_music: A low, tense string pulse at a moderate tempo, rising slightly
during the father's outburst, then fading under the held close-up.
这六段写完,一镜的提示词就齐了。 关键记住:对象用 <Subject N>、环境也是 <Subject N>、对话用 <d>[Chinese]、旁白用 off-screen voiceover + lips closed、音效只进 overall_soundscape。
四点五、参考图上传顺序与引用(必看)
很多人在这一步翻车:图传了、提示词写了,但角色串了、场景错了——**因为图片编号没对上**。
顺序:<Picture N> = 你上传的第 N 张图
图片编号就是上传顺序,第 1 张上传的就是 <Picture 1>,第 2 张是 <Picture 2>,以此类推。
以镜08(父子对峙)为例,我们在 H3OneNode(Chain 模式)的 Motion Context 区按这个顺序上传 3 张(第 1 张传的就是 <Picture 1>):
A_liwei.png | <Picture 1> | |
A_father.png | <Picture 2> | |
A_bedroom.png | <Picture 3> |
标记:<Subject N> = 你在 subject_definitions 里定义的第 N 个对象
定义顺序也不可乱,必须和图片顺序一一对应:
subject_definitions:
<Subject 1> is Li Wei in <Picture 1>, ... ← 第1个定义 → 引用第1张图(李伟)
<Subject 2> is the father in <Picture 2>, ... ← 第2个定义 → 引用第2张图(父亲)
<Subject 3> is the bedroom in <Picture 3>, ... ← 第3个定义 → 引用第3张图(卧室)
编号规律:<Subject N> 的 N 通常和 <Picture N> 的 N 一致——第 N 个角色 = 第 N 张图。官方允许一个角色来自多张图(appearance from <Picture 1> and motion from <Video 1>),但短剧最稳妥的写法就是 1 对 1。
引用:后面三处都用同一套编号
编号一旦定义,summary / retention_analysis / detailed_description 里全部复用,不能中途改名:
summary:
The target video shows <Subject 1> and <Subject 2> confronting inside <Subject 3>.
detailed_description:
[Shot 1] ... <Subject 1> (S1) sits in the gaming chair... <d>[Chinese] 我怎么了?</d>
[Shot 2] ... <Subject 2> (S2) shouts... <d>[Chinese] 你碍着我了!</d>
踩坑案例(我们真实遇到的)
第1集早期版本,镜06/19 上传参考图时把毕业典礼和客厅的顺序传反了,结果提示词里写
<Picture 1> 毕业典礼,实际第 1 张却是客厅——成片场景直接错乱。**核对方法**:提交前逐个看 Motion Context 区上传的图片文件名(点缩略图看),确认和提示词里<Picture N>一一对应。
五、四个真实踩过的坑(重点)
坑1:场景图只给一张,空间直接漂移
这是最隐蔽最致命的。我每个场景只生成 1 张空镜图。结果父亲破门那镜,H3 把卧室理解成"书架+衣柜"版本;母亲端面条进来那镜,画面里突然多出一扇"通向另一个房间的门"。
一张场景图覆盖不了多个机位。 同一个卧室,门口视角、床边视角、书桌视角,家具布局完全不同。H3 每次切镜都拿那唯一一张图当"场景真相",自然就飘了。
正确做法:每个重复出现的室内场景,至少生成 3 张不同机位的空镜(门口/床边全景/书桌角),全部作为参考图传进去,并在提示词里写明本镜用哪个视角。
坑2:动作写成旁白,观众听到的是"念稿"
“像冲出房间,这种明明就是动作,你也用旁白讲出来,你的提示词很有问题。”
镜18 本来是李伟听到客厅咳嗽、猛地冲出房间。我却在提示词里把"冲出房间"写进了旁白叙述。结果模型用旁白音色把这句话念出来,观众听到的是"李伟冲出房间"的画外音,而不是看到他冲出去。
物理动作只能写在视觉描述里(camera/动作),绝不进对话标签,也绝不写成旁白。
坑3:音效和台词写在一起,声音串轨
镜07 父亲破门,我既在画面描述里写"门被猛推开一声巨响",又在环境声段重复写"门撞墙巨响",还把父亲的怒吼台词放同一镜。结果渲染出来,旁白和父亲的声音混在一起,全成了父亲音色在读。
物理音效(巨响、咳嗽、碗放桌)只写在 overall_soundscape 段,和台词严格分层,绝不写进同一句。
坑4:别人台词借位到主角镜,旁白变女声
镜18 是李伟的卧室镜,我却把母亲在客厅的台词"老李!老李你怎么了!“写进这镜的对话里,还标了女声。观众在李伟卧室里突然听到陌生女声,像"旁白变成了女声”。
谁的台词,写在谁实际出声的那一镜。主角镜不借位别人的台词。全剧旁白音色在开头锁死一个,全程不变。
六、还有两个技术问题
1. 提示词格式不对,人物形象全崩
我一开始用自己理解的"一段式"描述,结果李伟中长发变短发、父亲加灰外套、背景漂移。改成官方六段式 + 角色 exactly as <Picture N> 锁定后,人物一致性立刻稳住。
2. ComfyUI 核心 bug
加"关键帧锚定"节点时,渲染直接报 shape invalid for input size 的 latent 错误。查官方兼容文档发现,这是 ComfyUI 在 2026-08-06 到 08-13 之间的 R2V 核心 bug,官方在 08-13 的提交 e01fb4c 修复了。
解决方法:更新 ComfyUI 核心(git fetch + git pull 到最新,重启服务)。如果你也遇到 H3 参考图视频报 latent 形状错误,先别怀疑自己,去查 ComfyUI 版本。
七、H3OneNode:一键直出的真相
很多读者会问:这一个节点,怎么就能生成整集?
机制:H3OneNode(魔改版)不是"真只有一个节点干活"——你点 Generate,它内部自动展开成完整的 22 段工作流(每段 = 采样链 + Motion Context 衔接),逐段渲染再拼接。前端一个节点,后端 300+ 节点。
我们用 fetch 拦截实测了它真实提交给后端的 API 工作流:
H3OneNode(Chain模式,22段)
↓ 点 Generate,内部展开
314 个节点(22段 × 每段采样链 + 模型加载 + Motion Context 衔接)
↓ 逐段渲染 + motion-context 运动衔接
完整一集 2分49秒
真实数据验证:拦截 POST /prompt 拿到的 API 工作流 = 314 节点、145KB,里面每一镜的提示词、参考图(ref_images)、分辨率、步数都是节点真实构建的,不是手写的——可以直接提交给 ComfyUI 后台渲染。
节点展开后的关键节点(抽查):
MiniMaxH3ReferenceToVideo | ||
MiniMaxH3MotionContext | ||
MiniMaxH3MotionContextSaveLatent/LoadLatent | ||
BasicGuider/SamplerCustomAdvanced/VAEDecode/CreateVideo/SaveVideo | ||
LoraLoaderModelOnly |
这就是"一键直出 3 分钟一集"的真相:你只面对一个节点,复杂全在它内部。
八、一集避坑指南(直接抄)
把上面所有教训浓缩成一份清单,下一集生产前对着过一遍:
生图阶段
每个重复室内场景,生成 ≥3 张不同机位空镜(门口/床边/书桌角),不是 1 张 多张空镜之间家具布局必须一致,是同一房间的不同角度
提示词阶段 3. 用官方六段式,角色后必写 exactly as <Picture N> + 锁外貌/服装 4. 物理动作(冲/走/推/倒)只写视觉段,不进对话、不写旁白 5. 音效(巨响/咳嗽/碗声)只写 overall_soundscape,不和台词同行 6. 谁的台词写在谁出声的镜,不借位;旁白音色全剧锁死一个
技术阶段 7. ComfyUI 报 latent 形状错误 → 先 git pull 更新核心到最新 8. 单镜先测 1 镜验证,再批量提交;渲染完逐镜抽帧核验
核验阶段 9. 每镜抽帧检查:人物发型/服装一致?场景背景没漂移?声音没串轨? 10. 发现问题只重渲那一镜,不必整集重来
九、成品与下一步
第一集最终成片 2分49秒、 竖屏、41MB,22 个镜头全部渲染成功。人物一致性达标,但场景空间漂移和声音串轨的问题,已经全部写进生产规范,下一集直接规避。
AI 短剧现在就能跑通"一人一显卡一晚上出一集"的工作流。瓶颈不在模型,在你把故事、参考图、提示词三件事对齐的能力。
这份避坑指南,就是帮你跨过那道门槛的。有什么好的方法,欢迎推荐,有什么问题还有交流。 要测试工作流的留言。
作者:AI老骥